

算力一断,再聪明的智能体也趴窝:今天这堂课必须补
导语
今天上午,DeepSeek崩了。网页、App、连同接它的API,一起趴了两个多钟头。几乎前后脚,腾讯那个WorkBuddy跳出一行字:模型资源紧张,前面排着约7265位用户。这两件事看着是两码事,说到底是一码事:现在的智能体,命都攥在别人家的算力手里。我这篇不打算掰扯谁崩了,就想说句实在话:智能体这行,真该补的短板在哪儿。
先看今天发生了什么
上午8点11分,DeepSeek的服务器开始出岔子。网页端、App、V4 Pro和V4 Flash的API一块儿停摆,官方状态页从正在排查一路改到已定位原因、正在修复,前后折腾了两个多钟头才算缓过来。
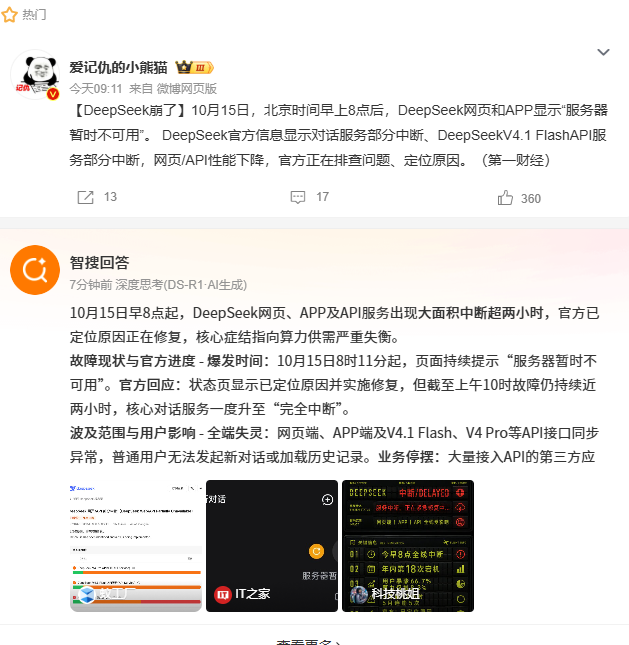
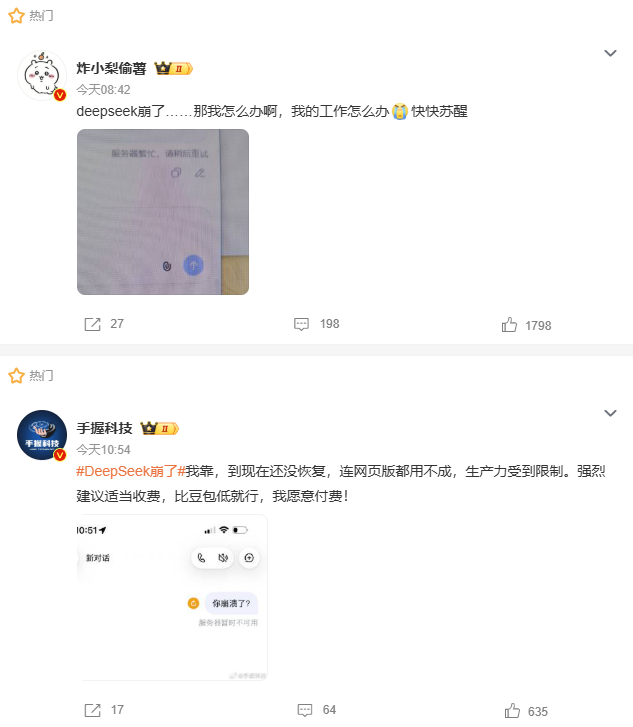
对一般用家来说,不过又是服务器繁忙那五个字。可对靠这些API吃饭的智能体厂商,这就是一次没打招呼的压力测试。
同一会儿,WorkBuddy弹出提示:当前模型资源紧张,已为您加入优先通道,前方约7265位用户排队。一个头部办公智能体,前头站了七千多人。
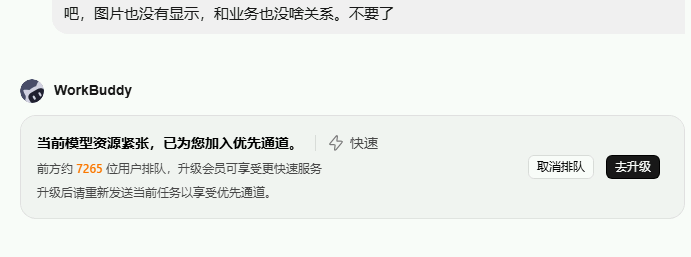
两件事搁到一条时间线上看,就没那么凑巧了。WorkBuddy自己的文档里写得明白,它能用deepseek-v4-pro接入,说白了也是在靠DeepSeek供血。上游的水管爆了,下游再灵光的智能体,也只能堵在那儿干排。
真正让人不安的,是单点依赖
让我心里犯嘀咕的,不是DeepSeek崩了,是它把智能体最要命的一处短板亮了出来:单点依赖。
传统软件对付的是写死的代码和数据库,出了毛病多数自己能修。现在的智能体不是那回事,它是一长串调用:读文件、拆任务、调模型、跑工具、交结果,一环扣一环。最要紧的那一环,恰恰是借来的模型算力。模型一断,整条链跟着瘫。你看到的不是某个接口超时,而是自己被请去排队、被请去升级会员。
再往深里说,你攥着的那摊业务,其实搁在别人家的机房里。产品做得再体面,只要底层算力是租的,人家宕机你就得跟着排。这怪不着哪一家厂商,这是智能体分工的代价:模型成了水电煤,而水电煤一旦断了供,不是你这一个下游能说了算的。
三个绕不开的局限
这一回,起码把大模型应用的三处毛病摆到了台面上。
头一桩,算力本来就紧张,排队是常事。七千多人的队说明,哪怕是头部厂商的成熟套餐,高峰时算力也是紧俏货。订阅解决的是能不能用,解决不了高峰够不够用。
第二桩,故障传得快,还只能单向传。智能体厂商对上游模型基本没啥缓冲。DeepSeek崩两个钟头,WorkBuddy就排两个钟头。故障不是慢慢渗下来的,是当头砸下来的,你连换手的机会都没有。
第三桩,应急的招太少。算力一出事,智能体顶多提示你排队、引导你升级、让你回头再试。对普通用家,除了等、除了换模型,手里没几张牌。可换模型三个字,对多数不爱折腾的人,门槛真不低。
算力断了,怎么救
问题越扎眼,越得给点能落地的办法。分三层说。
对智能体厂商,容灾得提前备好。第一,多模型冗余加自动降级:把DeepSeek、混元、GLM、Kimi摆成随时能换的备用水源,一察觉哪个不对劲,就把流量切到别的道上,别叫用户干等。第二,熔断加队列分级,高峰先放高优先级,低优先级的排队,别让全线一起堵死。第三,能自托管、能本地跑的模型留个底,要紧的活儿宁可慢,也不能断。
对用家,手里得有备份。要紧的活儿别只拴在一个工具、一个模型上。碰见排队就换模型、错峰用,把今天必须交的放到算力最松的时候。还得看懂模型资源紧张这句话:不是你哪做错了,是上游的算力在闹脾气。
对行业,透明和标准化才是治本。模型供应商该像电网那样把实时状态亮出来,开放容灾的口子;智能体之间最好有套通用接口,换模型像换电池那样省事。出了事故也得有交代、有补偿,不能撂一句去升级就让你自己消化。
DeepSeek现在的量,算是国民级的了。越是扛着千千万万人用的东西,崩一次,牵扯面就越宽。这一课,其实是给整个智能体行业上的:智能体的上限,是模型给的;可它的下限,得靠容灾兜着。谁先把算力断了怎么办想明白,谁才可能在这摊事里站得住脚。
往后比的,不只是谁的模型更聪明,还有谁能在坏天气里,照样不让你的活儿停摆。
